Probé GraphRAG con Neo4j, Qdrant y un LLM local pequeño: lo que midí (y lo que no funcionó)
Parte 1 de 1112 de octubre de 2026 · 5 min · David Silvente López
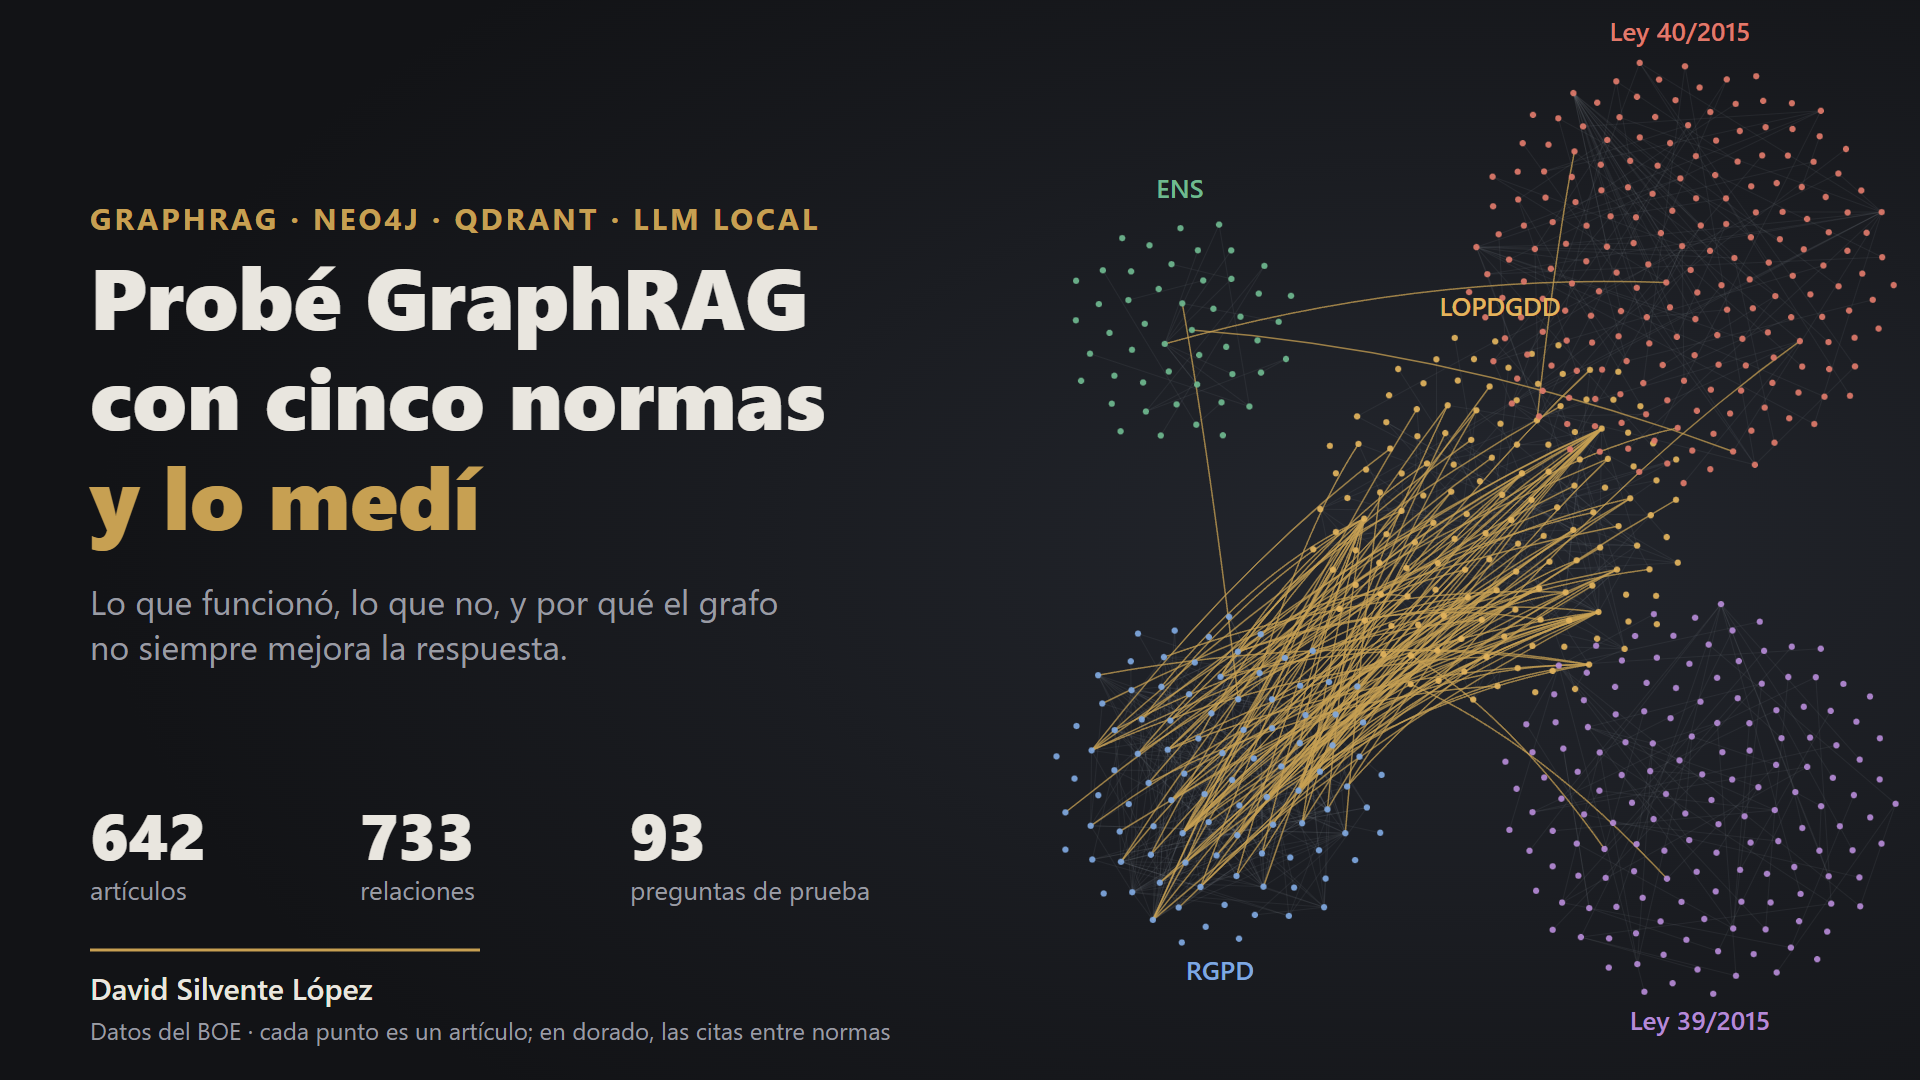
Este mes he completado las certificaciones de Neo4j (Fundamentals y GenerativeAI Fundamentals) y me hice una pregunta incómoda: ¿mejora de verdad un grafo de conocimiento lo que ya hace un buen RAG vectorial? En vez de creérmelo, lo medí, en un entorno cerrado en mi PC (Docker, sin GPU y sin salida a internet para la base de datos).
El experimento
Descargué del BOE, en datos abiertos, cinco normas que se citan constantemente entre sí: el Esquema Nacional de Seguridad, la LOPDGDD, el RGPD y las leyes 39/2015 y 40/2015. En total, 642 artículos. Cada artículo es un nodo; cada «según el artículo 24 del Reglamento (UE) 2016/679» es una arista: 599 referencias internas y 134 citas expresas entre normas.
Lo cargué en Neo4j, indexé los textos con embeddings en Qdrant y preparé 93 preguntas en lenguaje natural, cada una con los artículos que deben aparecer para poder responder. Después probé un LLM local pequeño (Qwen2.5 de 1,5B servido con vLLM en CPU) con cinco configuraciones de contexto. Cuatro cosas me llamaron la atención.
1. Neo4j hace exactamente lo mismo que el código en memoria, pero lo hace explicable
Cargué el grafo completo en un Neo4j real: conteos exactos, consultas de 2 a 4 milisegundos y la expansión de vecinos de GraphRAG calculada en Cypher da el mismo resultado que en memoria en las 93 preguntas. Para este tamaño no hace falta Neo4j para ir rápido (la memoria es 80 veces más veloz). Su valor es otro: consultar relaciones, ver caminos y auditar qué cita a qué. Por ejemplo, los artículos del RGPD más citados por otras normas son el 15 y el 22; y entre el artículo 3 del ENS y la disposición adicional primera de la LOPDGDD hay un solo salto.
2. El contexto lo es todo
Con el modelo pequeño solo, sin contexto, la puntuación media fue de 0,12 sobre 2: 15 de 16 respuestas incorrectas, con aplomo y citando artículos de códigos que no existen. Con contexto recuperado de las normas, la media subió a entre 1,1 y 1,4. La mayor mejora de todo el experimento no vino del grafo: vino de darle al modelo los artículos correctos.
3. Menos contexto, mejores respuestas
Con un modelo pequeño, cuatro artículos recortados a 1.200 caracteres (1.178 tokens) superaron a seis artículos completos (3.552 tokens): 1,44 frente a 1,12. Menos tokens y mejor respuesta. Añadir los vecinos del grafo no ayudó: GraphRAG subió la cobertura del contexto del 66 % al 78 %, pero la respuesta final fue peor (1,19 frente a 1,38 del híbrido con el mismo recorte), porque los artículos añadidos (infracciones, otras normas) distrajeron al modelo en 3 de 16 preguntas. Un vecino conectado no es lo mismo que un vecino útil.
4. El peligro real: seguro y equivocado
En 2 de 16 preguntas el artículo correcto no llegó al contexto, y las cinco configuraciones dieron una respuesta plausible y errónea. El modelo no se abstuvo ni una sola vez en las 80 respuestas, y casi nunca citó la fuente en el formato pedido. En normativa, eso es peor que no responder. Lo que haría falta no es un grafo más grande: es un umbral de confianza en la recuperación («no hay información suficiente») y una respuesta estructurada que obligue a citar.
Segunda vuelta: lo que sí movió la aguja
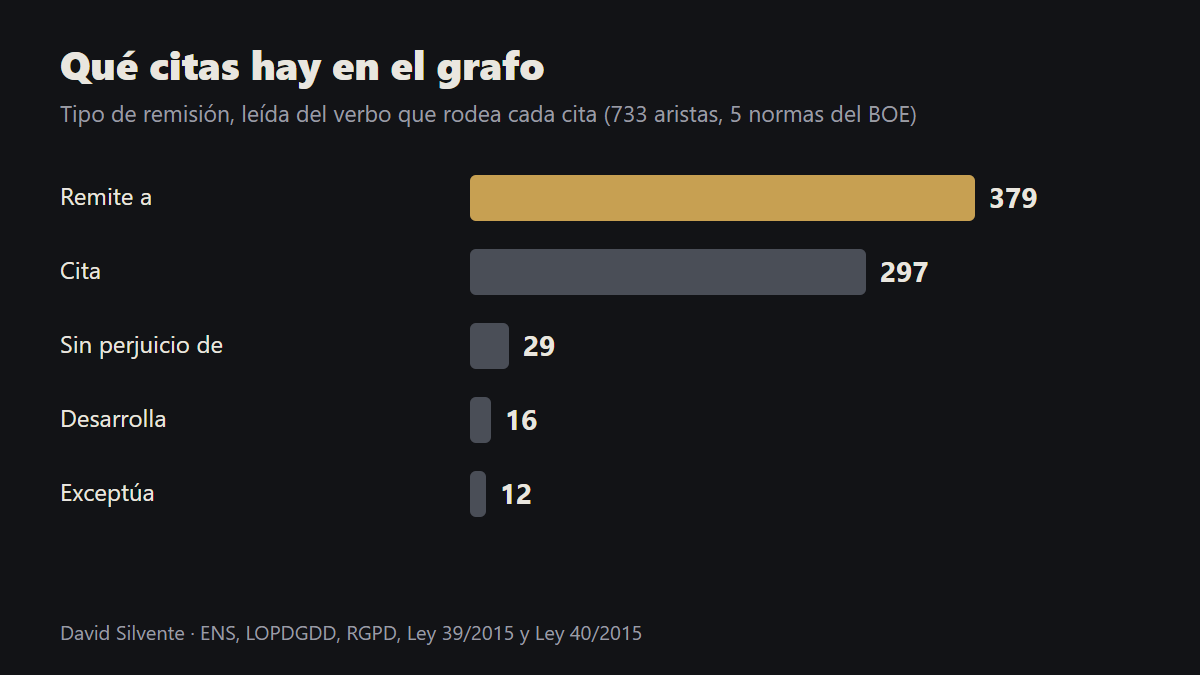
Mi primer grafo trataba igual «remite a», «sin perjuicio de» y «en desarrollo de». Lo rehice leyendo el verbo que rodea cada cita: 379 remisiones, 297 citas simples, 29 «sin perjuicio», 16 desarrollos y 12 excepciones. Enlacé también artículos con el mismo título entre normas (10 equivalencias seguras, como el delegado de protección de datos: art. 34 de la LOPDGDD y art. 37 del RGPD) y 50 conceptos compartidos. Cada tipo pesa distinto al elegir vecinos.
Después medí la recuperación en las 93 preguntas, con seis fragmentos de contexto y contando solo las preguntas con TODOS los artículos necesarios:
- Híbrido (léxico + vectorial): 61 %
- GraphRAG con tipos, sin reranker: 63 %
- Híbrido + reranker: 69 %
- GraphRAG con tipos + reranker: 72 %
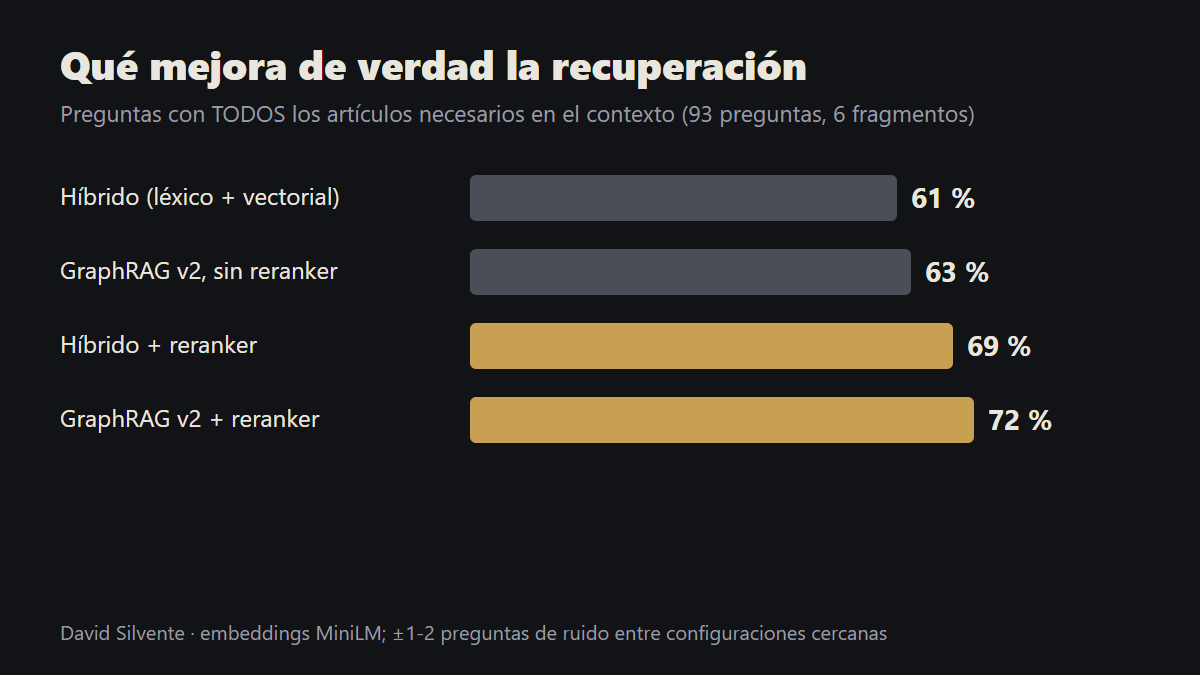
La lección: el reranker aporta unos 8 puntos; el grafo con tipos, 2-3 más, que están dentro del ruido de mi prueba (±1-2 preguntas). Lo más barato (un reranker) mejoró más que lo más vistoso (el grafo). Y las preguntas que cruzan normas siguen siendo el punto débil: solo se cubren del todo el 38 %.
Lo que no puedo afirmar
- Son 16 preguntas por experimento. Dos preguntas pesan más de diez puntos.
- Las puntuaciones las hice con ayuda de un asistente de IA que leyó cada respuesta frente al texto de la ley: es un solo lector y es subjetivo.
- Entre dos entornos distintos de la misma prueba (Windows y Linux) cambian una o dos preguntas por celda: la diferencia entre configuraciones pequeñas es ruido.
- Un modelo de 1,5B en una CPU tarda unos 35 segundos por respuesta. Es un prototipo, no un sistema.
Qué haré después
Probar modelos de 4 a 9B con respuesta estructurada y fuentes, calibrar un umbral de «no lo sé» con preguntas fuera de ámbito, y repetir la medición con más preguntas y un evaluador independiente. El código y el laboratorio son reproducibles.
Si trabajas con RAG sobre normativa o documentación con muchas remisiones, me encantaría saber qué has medido tú. ¿Te compensó el grafo, o te quedaste con el híbrido?
Preguntas frecuentes
¿Mejora GraphRAG a un buen RAG vectorial?
En esta prueba, poco: el grafo con tipos sumó 2-3 puntos sobre el híbrido, dentro del ruido. El reranker aportó unos 8 puntos.
¿Qué datos se usaron en la prueba de GraphRAG con Neo4j y Qdrant?
Cinco normas del BOE (ENS, LOPDGDD, RGPD y leyes 39/2015 y 40/2015) con 642 artículos, 93 preguntas y un LLM local pequeño (Qwen2.5 de 1,5B) en un entorno cerrado sin GPU.
¿Cuánto mejora un LLM pequeño al darle contexto recuperado?
Sin contexto la media fue 0,12 sobre 2, con 15 de 16 respuestas incorrectas; con contexto subió a entre 1,1 y 1,4. Cuatro artículos recortados a 1.200 caracteres superaron a seis completos: 1,44 frente a 1,12.
¿Para qué sirve Neo4j en un RAG si no es más rápido?
Para consultar relaciones, ver caminos y auditar qué cita a qué. Da el mismo resultado que el código en memoria en las 93 preguntas, con consultas de 2 a 4 ms, pero lo hace explicable.
¿Tienes un RAG o un proyecto de IA con normativa o documentación?
Te ayudo a medirlo antes de gastar: preguntas de prueba, recuperación, abstención y coste.
Agenda tu diagnósticoSígueme en LinkedIn, donde comento cada artículo · Compartir: LinkedIn · X